사용 가능한 분석
ETF·주차별 모든 대상 카드를 분모로 삼습니다. 중요한 정보 누락, 미지원 주장, 상품 해석 오류를 함께 판정합니다.
ASCEND AIOS · 업무 평가와 출판 검증 설계
대표 사례 / ETF 분석 산출물
NH ETF 제작 과정을 대표 사례로 검토했습니다. 가격을 요약하는 데 그치지 않고 상품 구조와 비교 맥락을 고객용 카드로 구성하는 작업입니다. 2026년 8월 28일 기준, 9월 3일 실행으로 기록된 배치의 코드와 보관 산출물을 대조했습니다.
ETF·주차별 모든 대상 카드를 분모로 삼습니다. 중요한 정보 누락, 미지원 주장, 상품 해석 오류를 함께 판정합니다.
타일뿐 아니라 본문·차트의 상품, 통화, 기간, 가격·총수익률 구분, 근거 시점을 확인합니다.
어떤 정보를 선택했고 상품 이해에 도움이 되는지 독립 실무자가 평가합니다. 유창한 설명만으로 성공을 판정하지 않습니다.
품질을 유지하면서 사람의 확인·수정 시간이 줄었는지, 새 자료에 맞춰 관련 설명이 정확히 갱신됐는지 측정합니다.
| 검사 대상 | 관측 결과 | 해석 범위 |
|---|---|---|
| 산출물 | 100 HTML · 100 PNG | 파일 존재 확인. 고객 전달이나 전체 화면 품질 인증은 아님 |
| 주요 수치 타일 | 265 / 300 | 재계산한 265개 일치. 나머지 35개는 재계산 대상 밖 |
| 문장 규칙 | 1,806 PASS | 기존 규칙의 미검출 재현. 사실 정확도나 규제 적합성 인증은 아님 |
가격 기준일과 메타데이터 조회일을 분리하고, 이벤트 근거를 실제 문장에 연결하며, 본문과 차트까지 수치 검사를 확장해야 합니다. 원 계산의 재생과 분석 내용의 독립 검증은 서로 다른 결과입니다.
실제 제작 흐름 보기5개 금융 리서치 유형
비검색 3종 · 검색 · 프로토콜
동일 가중치 단순 평균
조건별 단일 실행
250개 응답 파일 중 제외 문항을 뺀 245건을 재채점했습니다. 원 보고서 수치는 보존하되 지표 정의와 분모를 바로잡았습니다.
이 절차가 끝나기 전까지 결과를 국제학술지 검증이나 외부 인증으로 표현하지 않습니다.
01 / 연구질문
모델 순위가 아니라 최신 금융 리서치를 구성하는 데이터·근거·계산·보류 능력을 분리해 묻습니다.
전체 AIOS가 동일 기반모델+웹검색보다 필수 사실을 빠짐없이 맞히고 미확인 내용을 덧붙이지 않는 응답을 늘리는가? 시점 적격성은 별도로 판정합니다.
모델·검색 근거·예산을 고정했을 때 검증 절차가 근거로 확인된 필수 사실을 늘리면서, 응답 전체 지지율의 저하를 사전에 정한 허용폭 안으로 제한하는가?
보고값과 파생값을 올바른 단위·통화·기간·산식으로 재현할 수 있는가?
전제가 틀리거나 근거가 부족할 때 답을 꾸미지 않고 보류하거나 조건부로 답하는가?
02 / 예비평가 설계
원래 50문항에서 응답 수집 후 1문항을 제외해 49문항을 채점했습니다. 최신 기업 실적 9개, ETF·상품 15개, 시장 이벤트 10개, 규제·지수 방법론 10개, 함정 5개입니다. 수치 대조·기권 점수는 이 중 44문항만 사용하며, 수치 없는 정답 5개는 제외합니다.
원 패키지는 다섯 조건을 서브에이전트 환경에서 수집했다고 기록합니다. 비검색 모델 3종, Opus+검색, Opus+검색+ASCEND 프로토콜을 비교했으며 마지막 조건은 운영 AIOS가 아닙니다. 질문과 채점 규칙은 공유하지만 검색 권한·지시·절차는 다릅니다. 모델명은 원 기록의 표기이며, 제공자 실행을 독립 인증한 이름이 아닙니다.
03 / 측정 정의
현재 보고된 지표와 출판 검증에서 추가할 지표를 구분했습니다. 후자는 아직 측정 결과가 아닙니다.
원 보고서의 ‘사실 정확도’는 수치가 있는 40문항의 수치 토큰 충족률과 기권 대상 4문항의 표현 검출 점수를 평균한 값입니다. 부호를 무시하고 상대오차 2%를 허용하며, 주체·기간·방향·추가 주장은 판정하지 않습니다. 수치 없는 정답 5문항은 제외됩니다.
기권 대상 4문항 모두에서 보류 표현이 검출됐습니다. 설명의 정확성이나 허위 내용의 부재까지 확인한 것은 아닙니다. 5문항으로 구성된 함정 유형 점수와는 평가 대상이 다릅니다.
sources 항목이 비어 있지 않으면 점수를 줍니다. URL 유효성·1차 출처 여부·주장 지지는 검사하지 않으며, 프로토콜 조건은 49/49입니다. 이를 ‘1차 출처 부착’이라고 부르면 코드가 확인한 범위를 넘어섭니다.
asof_claimed 항목이 있거나 답변에 날짜 형태의 문자열이 있으면 점수를 줍니다. 올바른 날짜인지, 해당 주장의 기준일인지는 검사하지 않으며, 프로토콜 조건은 49/49입니다.
고정된 한국어 금지 표현과 주변 문맥의 예외 규칙으로 검사합니다. 메타 질문 2개를 제외한 프로토콜 조건은 47/47입니다. 법규 준수나 금융 조언의 안전성을 평가한 결과는 아닙니다.
반올림한 다섯 축에 각각 0.2의 가중치를 부여한 평균입니다. 축마다 분모가 다르고 같은 기권 4문항이 두 축에 들어갑니다. 97.3점은 정확하거나 안전한 응답이 97.3%라는 뜻이 아닙니다.
필수 사실을 모두 맞히고 추가 실질 주장까지 검증되어야 성공입니다. 사실 정밀도와 필수 사실 충족률은 별도 공개하며, 같은 사실을 반복해도 점수가 늘지 않습니다.
정확하고 시점 적격한 인용으로 완전히 지지된 고유 필수 사실을 셉니다. 응답 전체 지지율이 사전에 정한 허용 수준보다 낮아지지 않아야 하며, 인용 유무만으로 가점하지 않습니다.
정답표가 요구한 수치를 단위·통화·기간·산식·반올림까지 재현합니다. 어려운 계산을 답변에서 생략해도 평가 분모에서 빠지지 않습니다.
잘못된 전제나 근거 부족을 실제로 설명하고, 미확인 실질 주장을 만들지 않아야 합니다. 오류·시간초과·빈 답변은 안전한 보류로 인정하지 않습니다.
주장이나 인용이 없을 때 조건부 정밀도는 100%가 아니라 미정의로 남깁니다. 필수 내용 누락은 0점이며, 주 분석에서는 부분점수를 주지 않고 원개수를 함께 공개합니다.
04 / 예비평가 결과
점수는 0~100이며 종합점수는 반올림한 다섯 축의 동일 가중치 평균입니다. 원응답에서 채점을 재현했지만, 의존성·표본설계·평가 타당성이 확립되지 않았으므로 확증 신뢰구간이나 유의확률은 제시하지 않습니다.
| 평가 축 | Haiku 4.5 비검색 | Sonnet 5 비검색 | Opus 5 비검색 | Opus 5 + 검색 | ASCEND 프로토콜 |
|---|---|---|---|---|---|
| 수치 대조·기권 점수 · n = 44 | 23.0 | 39.1 | 51.0 | 88.6 | 86.6 |
| 기권 표현 검출 · n = 4 | 100 | 100 | 100 | 100 | 100 |
| 출처 목록 기재 · n = 49 | 0 | 0 | 0 | 100 | 100 |
| 기준일 표식 기재 · n = 49 | 49.0 | 49.0 | 57.1 | 95.9 | 100.0 |
| 금지 표현 미검출 · n = 47 | 100 | 100 | 100 | 97.9 | 100 |
| 종합 점수 | 54.4 | 57.6 | 61.6 | 96.5 | 97.3 |
| 문항 유형 | Haiku 4.5 비검색 | Sonnet 5 비검색 | Opus 5 비검색 | Opus 5 + 검색 | ASCEND 프로토콜 |
|---|---|---|---|---|---|
| 최신 기업 실적 · n = 9 | 5.2 | 5.9 | 10.4 | 100.0 | 97.2 |
| 최신 시장 이벤트 · n = 9 | 10.9 | 10.5 | 21.2 | 70.0 | 72.2 |
| ETF·상품 지식 · n = 12 | 15.1 | 58.8 | 70.4 | 85.0 | 85.0 |
| 규제·지수 방법론 · n = 9 | 31.5 | 49.0 | 76.5 | 94.3 | 85.3 |
| 함정 문항 · n = 5 | 80 | 85 | 85 | 100 | 100 |
| 보고 지표 | 웹검색 | + 프로토콜 | 관측 차이 |
|---|---|---|---|
| 종합 점수 | 96.5 | 97.3 | +0.8 |
| 수치 대조·기권 점수 | 88.6 | 86.6 | −2.0 |
| 키워드 Tier 1 · 원 보고 n = 50 | 22/50 · 44% | 35/50 · 70% | +26 pp |
| 키워드 Tier 1 · 적격 n = 49 | 21/49 · 42.9% | 34/49 · 69.4% | +26.5 pp |
| 키워드 Tier 3 · 원 보고 n = 50 | 18/50 · 36% | 12/50 · 24% | −12 pp |
05 / 기술적 절제실험
Opus 5로 표기된 비검색 조건은 61.6점, 검색 조건은 96.5점, ASCEND 프로토콜 조건은 97.3점입니다. 관측 차이는 +34.9점과 +0.8점이지만, 실제 AIOS의 데이터망·인과그래프·권한 분리·결정론적 게이트의 효과를 측정한 실험은 아닙니다.
조건별 1회 실행이며 검색 결과·응답 길이·배치 문맥이 통제되지 않아 인과효과로 해석하지 않습니다. 출처 키워드 등급은 높아졌지만 수치 대조·기권 점수는 88.6에서 86.6으로 하락했습니다. 이 하락이 안전한 보류인지, 정답 누락인지, 규칙의 한계인지는 독립적인 주장별 판정으로 구분해야 합니다.
Δ +34.9
Δ +0.8
사례 / 원응답 대조
49개 대응 문항 중 수치 점수는 3개 상승·38개 동일·3개 하락이며 5개는 미채점입니다. 점수가 달라진 6개를 모두 대조했지만, 이를 정답·오답의 승패나 전체 오류율로 해석하지 않습니다.
T3-09의 소제목 ‘2)’만 로마숫자로 바꾸면 수치 점수가 0.4에서 0.2로 바뀝니다. 금융 내용은 그대로입니다. 새 모델 응답이 아니라 채점기 민감도 시험입니다.
T4-02는 ‘해당 BIS 규칙’이라고 물었지만 입력에 규칙 식별자나 선행 문맥이 없었습니다. 답변의 오류와 문항의 불완전성을 별도로 판정해야 합니다.
프로토콜 답변은 검색 0건을 근거로 AMD 제품을 지명한 BIS 규칙이 없다고 단정했습니다. 공식 규칙의 설명부에서 반례가 확인됐습니다. 원문 위치와 주장 범위를 함께 평가해야 합니다.
과거 점수와 원응답은 변경하지 않았습니다. 이 사례는 공개된 개발 사례로 관리하며, 향후 독립 시험의 일반화 증거로 재사용하지 않습니다.
아키텍처 요구사항 보기통계 절차의 개발 검증 · 합성 자료
계산이 맞아도 표본에 맞는 검정은 아닐 수 있습니다. 후보 CR1-t 절차를 표준 패키지와 대조하고, 11개 조건에서 각각 10,000회 모의실험했습니다. 실제 AIOS의 성능 시험은 아닙니다.
30개 합성 대비에서 수치 계산은 statsmodels 0.14.6과 허용오차 10⁻¹¹ 이내로 일치했습니다. 그러나 실제 차이가 없는 균형 표본의 오탐률 4.80%가, 한 군집에 질문이 몰리면 21.90%로 높아졌습니다. 같은 문서·사건의 질문 수를 늘리는 것만으로 독립 증거가 늘지는 않습니다.
따라서 이 절차를 모든 표본에 적용 가능한 주 검정으로 승인하지 않습니다. 실제 연구의 군집·업무 구성·희귀 오류를 반영해 사전 검증하고, 적합하지 않으면 확증 결과를 보기 전에 표본 설계나 추론 방법을 바꿔야 합니다. 예비평가 97.3점에는 확증 p값이나 신뢰구간을 붙이지 않았습니다.
군집은 같은 문서·사건을 공유해 서로 의존할 수 있는 질문 묶음입니다. CR1-t는 군집을 고려한 평균차 검정의 후보입니다. 아래 95% MC 구간은 모의실험 비율의 오차이며, AIOS 효과의 신뢰구간이 아닙니다. 조건별 Wilson 구간으로, 여러 조건을 동시에 보장하지 않습니다.
| 합성 조건 | 오탐률 / 검정력 | 95% MC 구간 | 구간 포함률¹ | 판정 불가 |
|---|---|---|---|---|
| 균형 표본 · 실제 차이 없음 | 4.80% | 4.40%–5.24% | 94.85% | 0.00% |
| 독립 군집 6개 | 5.26% | 4.84%–5.71% | 93.71% | 0.00% |
| 195문항 중 100개가 한 군집 | 21.90% | 21.10%–22.72% | 71.43% | 0.00% |
| 군집 간 공통 충격을 누락 | 42.20% | 41.24%–43.17% | 18.15% | 0.00% |
| 군집별 차이가 드문 조건 | 0.08% | 0.04%–0.16% | 100.00% | 66.92% |
| 비열등성 경계 −0.03 | 4.94% | 4.53%–5.38% | 94.85% | 0.00% |
| 합성 효과 +0.12 · 검정력 | 99.22% | 99.03%–99.37% | 94.81% | 0.00% |
¹ 포함률은 구간을 계산할 수 있었던 반복만 분모로 합니다. 차이가 드문 조건의 100%는 3,308회에 대한 값이며, 나머지 6,692회는 판정 불가입니다. 모든 반복은 오탐률 분모에 남습니다. 마지막 행만 가정한 양의 효과에서의 검정력이고, 나머지는 귀무가설 경계의 오탐률입니다. 공통 충격 조건은 독립성 가정을 의도적으로 위반합니다.
| 참인 귀무가설 | 하나 이상 오탐 / 반복 | 가족단위 오탐률 | 95% MC 구간 |
|---|---|---|---|
| 네 연구질문 모두 귀무가설 참 | 336 / 10,000 | 3.36% | 3.02%–3.73% |
| RQ2 지지율 귀무가설만 참 | 439 / 10,000 | 4.39% | 4.01%–4.81% |
| RQ2 충족률 귀무가설만 참 | 479 / 10,000 | 4.79% | 4.39%–5.23% |
| RQ3 귀무가설만 참 | 482 / 10,000 | 4.82% | 4.42%–5.26% |
개발 검토 기준은 오탐률의 95% MC 상한 ≤6%, 계산 가능한 구간 포함률의 MC 하한 ≥94%, 판정 불가 ≤1%였습니다. 단일 대비에서는 6개 군집·편중 군집·공통 충격·희귀 차이 조건이 기준을 통과하지 못했습니다. 공동판정 네 조건의 통과도 이 생성분포에 한정됩니다. 다중비교 보정은 잘못된 개별 검정을 고쳐주지 않습니다.
시드 2026090301과 NumPy PCG64를 사용한 공개 전 개발 시험입니다. 계획·코드·환경·분자와 분모·실패 결과를 로컬 재현 자료에 보존했습니다. 공분산 계산 경로는 서로 다르지만 두 경로 모두 SciPy의 t분포를 사용하므로, 모든 수치 구성요소의 독립 구현 검증은 아닙니다. 실제 표본의 사전등록과 독립 검토는 남아 있습니다.
06 / 출판 검증 절차
아래 항목은 완료 사실이 아니라 국제학술지 투고 전 충족해야 할 검증 규격입니다.
RQ별 지표·분석 대상·비교조건·정밀도 목표를 0~1 척도로 고정합니다. RQ2는 근거로 확인된 필수 사실의 증가와 응답 전체 지지율의 비열등성을 모두 요구합니다. 예비 종합점수는 기술통계로만 유지합니다.
표본추출 틀·업무 구성·정밀도 목표와 문서·사건별 의존군을 데이터 분리 전에 고정합니다. 문항 수와 독립 군집 수를 따로 보고합니다. 49문항은 모집단을 대표하는 확증 표본이 아니라 예비평가입니다.
이 설계는 확률적 조건별 최소 5회를 제안하되, 최종 횟수는 예비 분산과 정밀도로 정당화합니다. 5회가 보편적인 충분조건은 아닙니다. 모델·프롬프트·도구·검색·평가일 버전을 고정합니다.
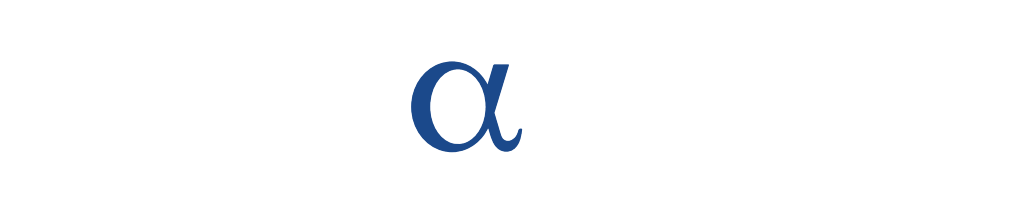
시스템 정보를 가린 금융 전문가 2명이 독립 평가하고 제3자가 불일치를 조정합니다. 원개수를 보존하고 HEDS 공개표를 작성하며 Krippendorff α 또는 적합한 대안 지표를 보고합니다.
반복은 문항 안에서 평균하고 문서·사건별 의존군을 보존합니다. 평균차 검정을 사전 검증한 뒤, RQ2의 우월성·비열등성 p값 중 큰 값을 사용하고 네 질문에 Holm 보정을 적용합니다. 개별 95% 구간은 동시 신뢰구간이 아닙니다.
게시일만 보지 않고 실제 원문 버전의 가용시각을 검증합니다. 의존 문항군은 개발·시험 세트에 중복되지 않아야 합니다. 과거 근거를 재생해도 모델이 학습한 사후지식은 제거되지 않으므로 사전 예측 검증과 구분합니다.
품질 지표와 함께 종단간 지연시간, 비용, 토큰, 검색량, 도구 실패율, 보류율을 보고합니다.
근거 없는 주장, 기간 오류, 단위·통화 오류, 오래된 근거, 잘못된 전제 수용, 검색 누락, 정책 오탐·미탐으로 오류를 공개합니다.
권리상 공개 가능한 문항 또는 대체 문항, 프롬프트, 모델·도구 버전, 원응답, 검색 근거, 채점 코드, 평가자 지침, 실행환경 명세를 공개합니다.
07 / 한계와 유효성 위협
내적·외적·구성·통계적 타당성의 위협을 함께 공개합니다.
49문항에서 예비 관측값을 얻었습니다. 세부 유형이나 모집단에 대한 주장에 충분한지는 문항 수만이 아니라 표본 선정·독립 군집·분산·정밀도 목표로 판단해야 합니다.
ASCEND가 문항, 정답표, 채점 코드, 검증 절차를 설계했습니다. 독립 재현이나 외부 판정은 아직 수행하지 않았습니다.
보고된 평가는 조건별 1회 실행입니다. 실행 간 분산과 순위 안정성을 추정하지 못합니다.
로컬 감사에서 적격 채점 245건과 저장된 요약값을 모두 재현했습니다. 다만 응답 파일의 모델명만으로 제공자 실행, 정답표 접근 차단, 도구 기록의 완전성을 독립적으로 확인할 수는 없습니다.
평균 응답 길이는 130자에서 1,205자였습니다. 장문 답변은 규칙 기반 대조에 노출되는 후보 수치가 더 많을 수 있습니다.
리서치 검색과 검증만 평가했습니다. 포트폴리오 구성, 위험관리, 적합성, 주문 실행, 실현 수익률은 검증하지 않았습니다.
여러 문항이 같은 원천·사건·틀을 공유할 수 있습니다. 반복 호출과 유사 문항을 늘린 만큼 독립 증거가 늘지는 않습니다. 표본설계의 정당화 없이 일반 문항 검정을 확증 결과로 쓰지 않습니다.
현재 모델은 모든 인용이 기준일 이전이어도 이후 결과를 알고 있을 수 있습니다. 날짜 제한 검색은 모델의 기억 삭제가 아니며, 적격 인용만으로 당시 가능한 예측임을 입증할 수 없습니다.
원 패키지는 d_aios가 서브에이전트 환경의 프로토콜 구현체라고 명시합니다. 이 점수로 운영 데이터망·인과그래프·멀티에이전트 권한 경계·결정론적 통제의 효과를 주장할 수 없습니다.
응답을 확인한 뒤 문항 1개를 제외했고, 채점기 보정 5건도 기록돼 있습니다. 모든 조건에 대칭적으로 오류를 고쳤더라도 사전등록된 확증 시험이 되는 것은 아닙니다.
직접 구성한 채점기 반례에서는 부호나 기업이 달라도 수치가 같으면 만점을 받았습니다. 이는 규칙의 사각지대이며 모델의 실제 오류율을 측정한 결과가 아닙니다. 독립적인 의미 판정이 필요합니다.
08 / 선행연구와 기준
금융 QA, 인용 평가, 다중 지표, 통계추론, 생성형 AI 위험관리의 1차 문헌을 기준으로 보완했습니다.
Gao et al. · EMNLP 2025
과거 날짜를 지시해도 학습된 미래 사실의 간접 사용이 남을 수 있어 별도 시험이 필요합니다.El Lahib et al. · ACL 2026 · Short Papers
검색 날짜 필터와 실제 원문 버전의 가용시각 검증이 다르므로 원문 스냅숏이 필요함을 보여줍니다.Liu et al. · EACL 2026
금융 예측 등을 포함해 시간 누출과 과제 품질을 별도로 측정하는 비교 기준입니다.Cameron and Miller · Journal of Human Resources, 2015
문서·사건별 의존성을 무시하고 모든 문항·반복 호출을 독립 표본으로 세지 않도록 하는 근거입니다.Min et al. · EMNLP 2023
필수 정답과의 일치뿐 아니라 응답의 모든 원자 주장을 판정해야 하는 근거입니다. 별도로 설계한 정답 충족률과 완전 응답 지표를 FActScore 결과로 부르지 않습니다.Gao, Yen, Yu, and Chen · EMNLP 2023
답변 품질과 인용의 정확성·완전성을 분리해 측정하며, 주장 단위 근거 정밀도와 재현율 설계의 기준이 됩니다.Islam et al. · arXiv 2023
근거가 연결된 실제 금융 문항과 시스템 구성별 수동 검토 사례를 제공합니다.Kabra et al. · Financial Narrative Processing Workshop, 2026
기업 금융 환경에서 추론 시점 근거화, 환각 통제, 문서 구간 추적성을 운영 관점으로 평가한 직접적인 비교 연구입니다.Tang et al. · ACL 2025
실행 가능한 금융 계산, 명시적 풀이 프로그램, 문항 오류 정정, 폭넓은 금융개념 범위를 요구하는 근거입니다.Chen et al. · EMNLP 2021
금융 근거와 수치 추론 과정을 독립적인 평가 객체로 다룹니다.Zhu et al. · ACL-IJCNLP 2021
표·본문·기호 계산을 넘나드는 금융 추론을 별도로 평가해야 하는 근거를 제공합니다.Liang et al. · TMLR 2023
동일 조건, 다중 지표, 프롬프트와 원응답 공개를 포함하는 투명한 평가 원칙을 제시합니다.Koehn · EMNLP 2004
대응 재표집의 기반 연구이며, 실제 표본 단위와 문항 간 의존성은 본 연구에 맞춰 별도로 설정해야 합니다.Peyrard, Zhao, Eger, and West · ACL-IJCNLP 2021
같은 문항으로 비교한 시스템을 독립 평균만으로 순위화하지 말고 문항별 대응구조를 보존해야 하는 근거입니다.Belz and Thomson · GEM² 2025
인간평가의 설계·평가자·도구·품질관리·재현성을 일관되게 공개하는 표준 기록 양식입니다.Godbole and Jia · Findings of ACL 2025
자동 사실성 지표끼리 불일치하고 품질을 잘못 추정할 수 있음을 보여주며, 자동 채점만으로 결론내리지 않고 금융 도메인 검증과 눈가림 인간 판정을 병행해야 하는 근거입니다.NIST · NIST AI 600-1, 2024
생성형 AI의 측정, 문서화, 인간 감독, 잔여 위험 공개 기준을 제공합니다.판정
원 보고서의 채점은 재현됐지만, 지표의 의미와 운영 시스템의 효과는 별도 검증 대상입니다. 다음 연구는 동결된 운영 구현, 새로운 평가 표본, 독립 판정과 의존성을 반영한 추론을 갖춰야 합니다. 현재 97.3점을 운영 AIOS의 성능 인증으로 사용하지 않습니다.
기술 아키텍처와 검증 규격 보기